
Claude Code für Home Assistant: KI als Systemadmin
Entity-Leichen, Datenbank-Hygiene, Updates und Fehlerdiagnose

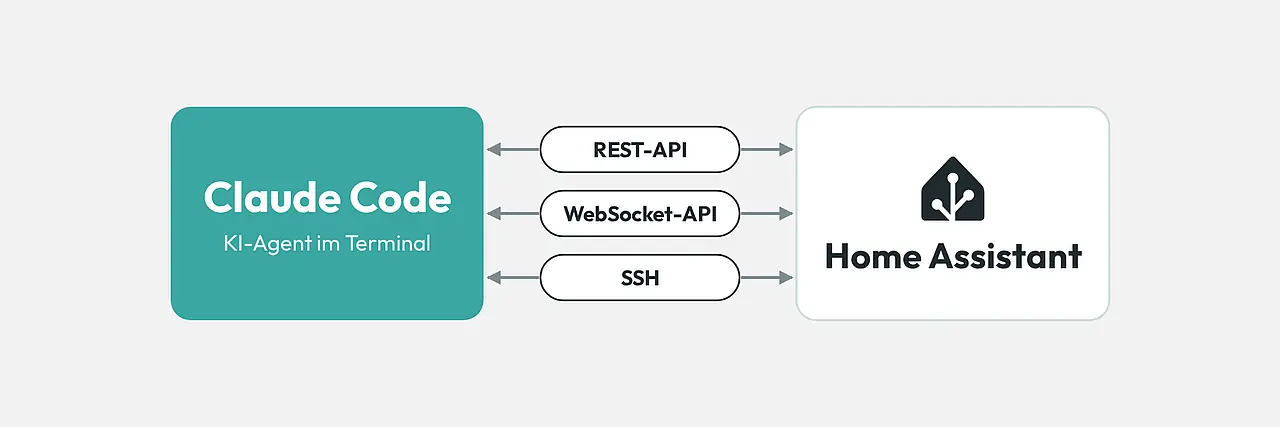
Kein Sprachassistent, keine Cards: Ich nutze Claude Code als Administrator für mein Home Assistant. Entity-Leichen, eine überlaufende Datenbank, ein Update mit 33 Paketen und ein verschwundenes Zigbee-Ventil. Was gut lief, was schiefging und welche Regeln daraus entstanden sind.
Wenn von KI und Home Assistant die Rede ist, geht es meist um Sprachassistenten. Licht an per Zuruf, ein LLM als Gesprächspartner in Assist. Das ist nett. Aber es ist nicht das, was mir in den letzten Monaten am meisten geholfen hat.
Ich nutze Claude Code als eine Art Systemadministrator für mein Home Assistant. Claude Code ist ein KI-Agent von Anthropic, der im Terminal läuft. Er liest Dateien, führt Befehle aus, ruft APIs auf und schreibt Skripte. Er redet nicht nur über dein System. Er schaut hinein.
Ja, ich entwickle damit auch eigene Integrationen und Lovelace-Cards. Darum geht es hier aber ausdrücklich nicht. Dieser Artikel handelt von allem anderen: Aufräumen, Diagnose, Updates, Datenbankpflege. Die Arbeit, die in jedem gewachsenen Smart Home anfällt und die niemand gerne macht.
Mein System ist kein Spielzeug. Rund 360 Geräte, gut 4.700 Einträge in der Entity-Registry, 125 Homematic-Geräte über eine CCU3, dazu Zigbee2MQTT, Fritz!Box, Reolink und einiges mehr. Zwölf Dashboards, 80 Automationen. Also genau die Art Installation, in der sich über Jahre Ballast ansammelt.
Wie das Setup aussieht
Claude Code läuft bei mir nicht auf dem Home-Assistant-Server, sondern auf meinem Arbeitsrechner. Unter Windows in WSL, aufgerufen aus dem Editor heraus. Von dort greift es über drei Wege auf das Produktivsystem zu. Zum Vergleich steht der MCP-Server von Home Assistant mit in der Tabelle:
| Zugang | Was Claude damit sieht | Wofür ich es nutze |
|---|---|---|
| REST-API | States, Verlauf, Konfiguration einzelner Automationen und Skripte | schnelle Abfragen, aktueller Zustand einer Entity |
| WebSocket-API | Entity- und Device-Registry, Config-Entries, Recorder-Statistiken, Dashboard-Konfigurationen | Aufräumen, Dashboard-Abgleich, Statistiken löschen |
| SSH aufs Terminal-Add-on | /config mit YAML-Dateien, .storage-Ordner, Recorder-Datenbank | Datenbankanalyse, Templates anpassen, Volltextsuche |
| MCP-Server (seit HA 2025.2) | Geräte steuern, Zustände abfragen | Alltagssteuerung, für Administration ungeeignet |
REST- und WebSocket-API brauchen einen Long-Lived Access Token. Den legst du in deinem HA-Profil unter „Sicherheit“ an. Das eigentlich Interessante liegt in der WebSocket-API. Die Entity- und Device-Registry gibt es nur dort.
Der MCP-Server ist für Alltagssteuerung der richtige Weg. Für Administration reicht er nicht. Wer Registry-Leichen finden oder die Datenbank analysieren will, braucht den Blick unter die Haube.
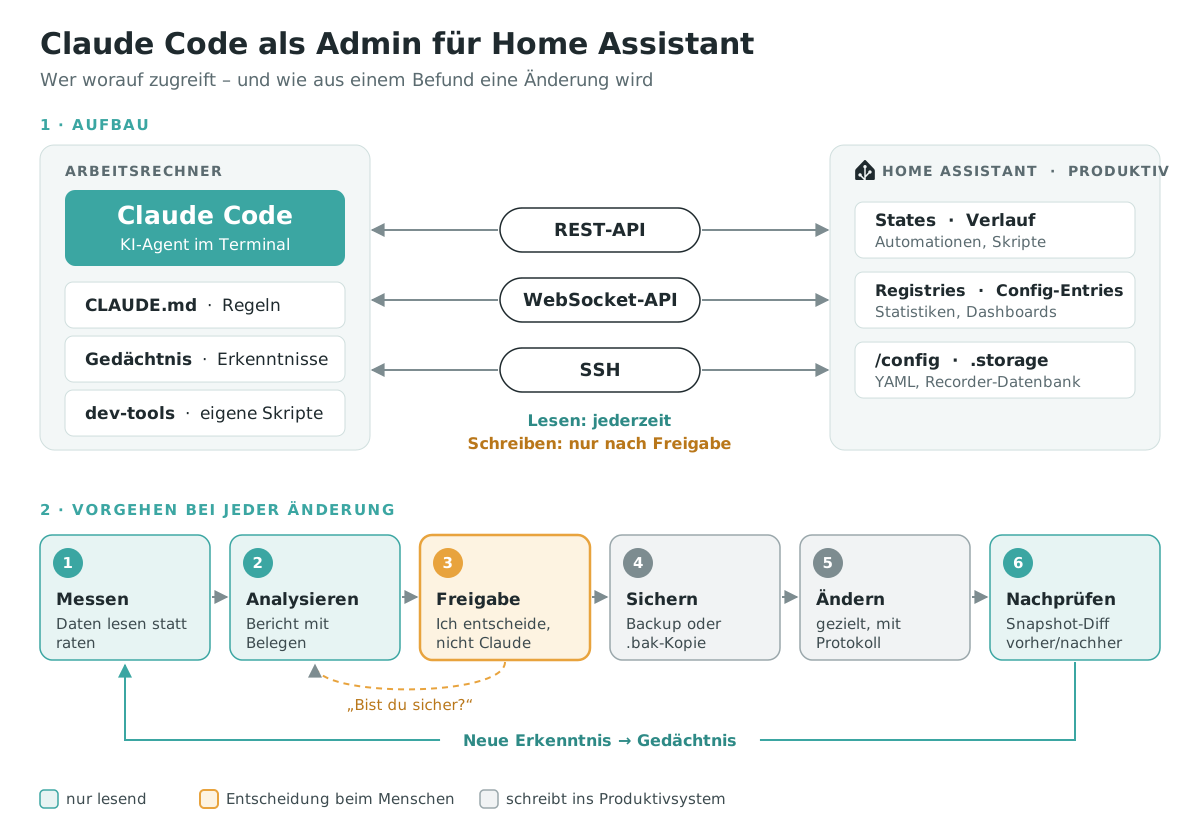
Die Spielregeln: Lesen ja, Ändern nur nach Freigabe
Bevor es um Beispiele geht, das Wichtigste. Ein KI-Agent mit Schreibzugriff auf dein Produktivsystem ist ein echtes Risiko. Das sage ich nicht aus Vorsicht. Ich habe es erlebt, dazu später mehr.
Claude Code liest beim Start eine Datei namens CLAUDE.md im Projektordner. Dort stehen Regeln, die für jede Sitzung gelten. Meine wichtigsten:
- Am Produktivsystem darf Claude frei lesen, analysieren und debuggen.
- Jede Änderung braucht meine ausdrückliche Freigabe. Keine Neustarts, keine Config-Änderungen, keine Deployments auf eigene Faust.
- Vor jedem Eingriff wird gesichert. Bei Dateien eine .bak-Kopie, bei größeren Aktionen ein vollständiges HA-Backup.
- Bei Problemen wird analysiert und berichtet. Nicht durch Neustarts „gefixt“.
Zusätzlich arbeite ich mit Claudes Gedächtnisfunktion. Claude Code legt dafür Notizen in einem Memory-Ordner ab, die in späteren Sitzungen wieder geladen werden. Dort landen Erkenntnisse wie „SSH-Zugang funktioniert, aber auf dem Host gibt es kein Python“ oder „Diese 50 Config-Entries sind absichtlich ignoriert, nicht kaputt“. Das spart enorm Zeit. Und es senkt die Chance, dass derselbe Fehler zweimal passiert.
Für die CCU3 habe ich einen eigenen Benutzer angelegt, statt Claude das Admin-Passwort aus der HA-Konfiguration nehmen zu lassen. Das gleiche Prinzip wie bei menschlichen Kollegen: eigene Zugangsdaten, nachvollziehbar, jederzeit entziehbar.
Werkzeuge, die Claude sich selbst gebaut hat
Eine der unterschätzten Stärken: Claude baut sich bei Bedarf die passenden Werkzeuge. Statt jedes Mal dieselben API-Aufrufe zusammenzustückeln, liegen bei mir inzwischen ein paar kleine Skripte in einem dev-tools-Ordner. Alle von Claude geschrieben, alle aus konkreten Problemen entstanden.
Ein Snapshot-Werkzeug. Es speichert den kompletten Zustand des Systems: alle States, Config-Entries, Registries, Repair-Issues. Ein zweiter Aufruf vergleicht zwei Snapshots. Heraus kommt eine Liste: welche Entities verschwunden sind, welche neu ausgefallen sind, welche Integrationen nicht mehr laden. Vor und nach jedem Update ist das Gold wert.
Ein WebSocket-Client. Klingt banal, war es nicht. Die erste Version starb nach wenigen Minuten bei jeder längeren Verbindung. Ursache: Home Assistant schickt Pings, und das Skript hat sie nicht beantwortet. Claude hat das gefunden und behoben.
Ein Live-Mitschnitt mit Kontext. Das ist mein Lieblingswerkzeug. Jeder Schaltvorgang in Home Assistant trägt einen context. Daraus lässt sich ablesen, ob ein Mensch, eine Automation oder das Gerät selbst geschaltet hat. Die History-API zeigt diesen Kontext nicht. Wer wissen will, warum um drei Uhr nachts das Licht angeht, braucht einen Mitschnitt.
Ein Screenshot-Werkzeug. Mit Playwright öffnet Claude ein Dashboard im Browser, macht Screenshots und sammelt die Fehler aus der Browserkonsole. Damit sieht Claude kaputte Karten, ohne dass ich ihm Bildschirmfotos schicken muss.
Ein Doppel-Check für Frontend-Module. Dazu gleich mehr.
Keines dieser Werkzeuge ist kompliziert. Aber ich hätte mir keines davon selbst geschrieben. Der Aufwand stand nie im Verhältnis zum Problem. Für Claude ist so ein Skript eine Sache von Minuten.
Entity-Leichen finden und sicher entfernen
Jedes ältere Home Assistant schleppt Entities mit sich herum, die es nicht mehr gibt. Integration entfernt, Gerät ersetzt, Sensor umbenannt. Die Einträge bleiben in der Registry, tauchen als „nicht verfügbar“ auf und verstopfen die Suche.
In meinem System standen weit über hundert Entities auf „nicht verfügbar“. Naheliegend wäre: alles löschen, was unavailable ist. Genau das wäre falsch gewesen.
Claude hat ein strengeres Kriterium angelegt. Gelöscht wurde nur, was zwei Bedingungen erfüllt: State unavailable und das Attribut restored: true. Dieses Attribut setzt Home Assistant, wenn eine Entity nur noch aus dem gespeicherten Zustand wiederhergestellt wird. Die Integration legt sie nicht mehr an. Eine Entity, die nur gerade offline ist, hat dieses Attribut nicht.
Vor jeder Löschung liefen zwei Prüfungen. Erstens die HA-eigene Beziehungssuche. Zweitens ein Volltext-Scan über alle zwölf Dashboards, alle Automationen, Skripte, Szenen und das Energie-Dashboard. Der zweite Scan ist nötig, weil die eingebaute Suche keine Entity-IDs findet, die in Jinja-Templates innerhalb von Karten stehen.
Und ein Detail, das ich nicht vorhergesehen hätte: Beim ersten Durchlauf waren 13 Kandidaten zwischenzeitlich wieder lebendig. Deshalb liefen alle Prüfungen unmittelbar vor dem Löschen noch einmal frisch gegen das Live-System. Nicht gegen einen Snapshot von vor einer Stunde.
Das Ergebnis: Echte Leichen waren 87. Zwei Löschwellen, 87 Einträge entfernt, null Fehler im Log. Registry von 4.762 auf 4.675 Einträge.
Was „nicht geladen“ wirklich bedeutet
Bei den Config-Entries ist Claude zunächst ein Fehler unterlaufen, aus dem ich viel gelernt habe. 78 Integrationen standen auf „nicht geladen“. Claude hatte das als kaputten Rest gelesen und 24 davon zum Löschen empfohlen.
Mir fiel auf, dass powercalc und ZHA in der Liste fehlten, obwohl sie ebenfalls auf „nicht geladen“ standen. Ich habe nachgefragt, warum. Erst daraufhin hat Claude das Feld source geprüft. Das Ergebnis: 72 der 78 Einträge hatten source: ignore. Darunter 50 powercalc-Vorschläge für virtuelle Verbrauchssensoren und ZHA, weil bei mir Zigbee2MQTT den Zigbee-Stick betreibt. Das sind Entdeckungen, die ich irgendwann mit „Ignorieren“ weggeklickt habe. Home Assistant legt dafür einen Eintrag an, der absichtlich nie lädt. Löscht man ihn, kommen die Vorschläge sofort zurück.
Die Lehre: Ein Agent, der schnell eine plausible Erklärung findet, ist nicht automatisch richtig. Rückfragen lohnen sich.
Dashboards reparieren nach Umbenennungen
Entity-IDs ändern sich gelegentlich, ohne dass du es merkst. Bei mir hatten die Fritz!Box-Entities irgendwann deutsche statt englischer IDs. Aus connection wurde verbindung, aus reboot wurde neu_starten. Die Dashboards zeigten danach „Entität nicht verfügbar“.
Claude hat alle Dashboard-Konfigurationen über die WebSocket-API gelesen und gegen die aktuelle Registry abgeglichen. Heraus kam eine Liste mit elf toten Verweisen auf vier Dashboards, jeweils mit dem passenden Nachfolger. Dazu drei kaputte Sankey-Karten für den Energiefluss.
Nach der Reparatur lief die Endkontrolle: zwölf Dashboards, null tote Verweise, null fehlende Custom-Karten. Diesen Punkt konnte ich mit gutem Gewissen abhaken, weil er auf einer Messung beruhte und nicht auf einem Gefühl.
Doppelt geladene Frontend-Module
Im Log stand dutzendfach eine Warnung von card-mod: Das Modul sei offenbar doppelt geladen. Bei der Ursachensuche kam heraus, dass das nicht nur card-mod betraf. Mehrere Frontend-Module wurden doppelt geladen. Einmal als Lovelace-Ressource, einmal über extra_module_url in der configuration.yaml. Zwei verschiedene URLs bedeuten für den Browser zwei verschiedene Module. Doppelter Download, doppeltes Parsen.
Allein custom-brand-icons brachte 4,5 MB doppelt auf die Waage. Bei insgesamt gut 17 MB JavaScript pro Seitenaufbau ist das ein spürbarer Anteil, besonders auf dem Wandtablet.
Das Tückische: HACS legt den Ressourcen-Eintrag bei jedem Update neu an. Aufräumen hilft also nur bis zum nächsten Update. Deshalb gibt es jetzt ein kleines Skript, das ich nach jedem HACS-Update starte. Es meldet doppelt geladene Module. Die Regel dahinter ist einfach: pro Modul genau eine Quelle.
Die Recorder-Datenbank unter Kontrolle bringen
Meine Datenbank war knapp 1 GB groß und wuchs um etwa 500 MB pro Jahr. Wie der Recorder grundsätzlich funktioniert, steht in meinem Artikel über Recorder und Datenbankgröße. Hier geht es um die Frage, wo genau das Wachstum herkam.
Claude hat die Datenbank per SSH vom Server kopiert und lokal mit SQL ausgewertet. Auf dem Home-Assistant-Host selbst gibt es weder Python noch SQLite. Die Analyse brachte einen klaren Hauptverdächtigen.
42 Sensoren für Wecker, Timer und Erinnerungen, größtenteils aus der Alexa-Integration. Sie stehen fast immer auf unknown. Trotzdem schrieben sie alle 84 Sekunden eine neue Zeile mit ihren Attributen. Zusammen machten sie 71,8 Prozent der Attribut-Tabelle aus. Für Daten, die niemand je angeschaut hat.
Dazu kamen 40 Leistungssensoren von powercalc, also geschätzte Momentanwerte. Die Energiezähler daraus brauche ich. Die Momentanwerte nicht.
Beides wurde in der Recorder-Konfiguration ausgeschlossen. Danach hat Claude die Langzeitstatistiken der ausgeschlossenen Sensoren gelöscht, nach Rückfrage und Liste für Liste. Das Ergebnis:
| vorher | nachher | |
|---|---|---|
| Datenbankgröße | 997 MB | 818 MB |
| Statistik-IDs | 750 | 530 |
| Wachstum pro Jahr | ≈ 500 MB | ≈ 353 MB |
Die eingesparten 180 MB sind schön. Wichtiger ist die gebremste Wachstumsrate. Langzeitstatistiken löscht Home Assistant nie automatisch. Sie sind der einzige Teil der Datenbank, der unbegrenzt wächst.
Drei Dinge, die du nicht raten solltest
Bei dieser Arbeit sind drei Verhaltensweisen von Home Assistant aufgetaucht, die ich so nicht erwartet hätte. Alle am laufenden System gemessen:
- recorder.purge mit apply_filter: true löscht keine Statistiken. Es räumt nur states und events auf. Ausgeschlossene Sensoren behalten ihre Langzeitstatistik. Die musst du separat entfernen, etwa unter Entwicklerwerkzeuge → Statistiken.
- Ein Timeout beim Löschen von Statistiken ist kein Fehlschlag. Die WebSocket-Antwort läuft ab, Home Assistant löscht im Hintergrund weiter. Nachzählen statt der Meldung glauben.
- Die History-API taugt nicht zur Kontrolle, ob ein Ausschluss greift. Sie liefert am Anfang jedes Zeitfensters einen künstlichen Randwert. Der sieht aus wie ein echter Eintrag. Ist er aber nicht. Verlässlich ist nur eine SQL-Abfrage gegen die Datenbank.
Gerade der dritte Punkt hätte fast zu einer falschen Erfolgsmeldung geführt.
Fehlerdiagnose: Das Zigbee-Ventil, das verschwand
Mein Bewässerungsventil, ein Sonoff SWV, war plötzlich weg. Batterien in Ordnung, am Gerät selbst ließ es sich schalten. In Home Assistant: nichts.
Claude hat zuerst eine Zeitleiste rekonstruiert. Aus den Zigbee2MQTT-Logs, dem Erstellungsdatum der Entities in der Registry, dem lastSeen-Wert und einem Netzwerkscan.
Die Zeitleiste zeigte ein Muster, das ich nicht gesehen hätte. Das Ventil hatte schon Tage vorher Probleme. Erste Schaltbefehle liefen ins Timeout, das Gerät sendete aber weiter. Dann scheiterten auch Lesezugriffe. Daraufhin wurde das Ventil dreimal aus Zigbee2MQTT entfernt. Keiner dieser Befehle wurde bestätigt. Kurz danach habe ich es neu angelernt. Gut zehn Minuten später war es wieder weg. Der Netzwerkscan zeigte: kein einziger Router kannte das Ventil noch.
Die Diagnose: kein Reichweitenproblem, keine Batterie, kein Hardwaredefekt. Das Gerät hatte das Zigbee-Netz verlassen. Wahrscheinlichster Auslöser: Einer der unbestätigten Entfernungsbefehle hat das Ventil verspätet doch noch erreicht, also erst nach dem Neuanlernen.
Wichtig fand ich, was danach kam. Claude hat nicht bei der Vermutung aufgehört. Nach dem Neuanlernen am Einbauort liefen drei Reproduktionstests: 82 Minuten Dauerlast, ein Kurzlauf und eine manuelle Bedienung am Gerät. Sechs Befehle, sechs Bestätigungen, null Timeouts. Der Bericht sagt deshalb ehrlich: Einzelereignis, Ursache wahrscheinlich, aber nicht mehr beweisbar.
Von Hand hätte ich mir diese Analyse kaum angetan. Zu viele Logdateien, zu viele Zeitstempel. Claude hat sie zusammengeführt und den Test mit einem Mitschnitt der MQTT-Nachrichten belegt.
Wenn die Messung lügt
Ein Gegenbeispiel gehört dazu. Ein Nous-Schaltmodul für meine Hi-Fi-Endstufen meldete „aus“ und 0 Watt. Ich war sicher, dass die Endstufe trotzdem lief.
Claude konnte das aus den Daten nicht bestätigen. Logisch, denn die Daten kamen vom defekten Gerät selbst. Das Modul meldete nur den kommandierten Zustand, nicht den tatsächlichen. Die Ursache fand ich mit dem Ohr: Das defekte Modul klackte beim Schalten deutlich leiser als das baugleiche daneben. Verschweißte Relaiskontakte, typisch bei Lasten mit hohem Einschaltstrom. Die Endstufe hängt seitdem am zweiten Kanal des Moduls.
Seitdem steht in meinen Regeln: Widerspricht eine Messung meiner Beobachtung, gilt die Beobachtung. Ein Agent sieht nur, was das System ihm zeigt.
Große Updates planen und begleiten
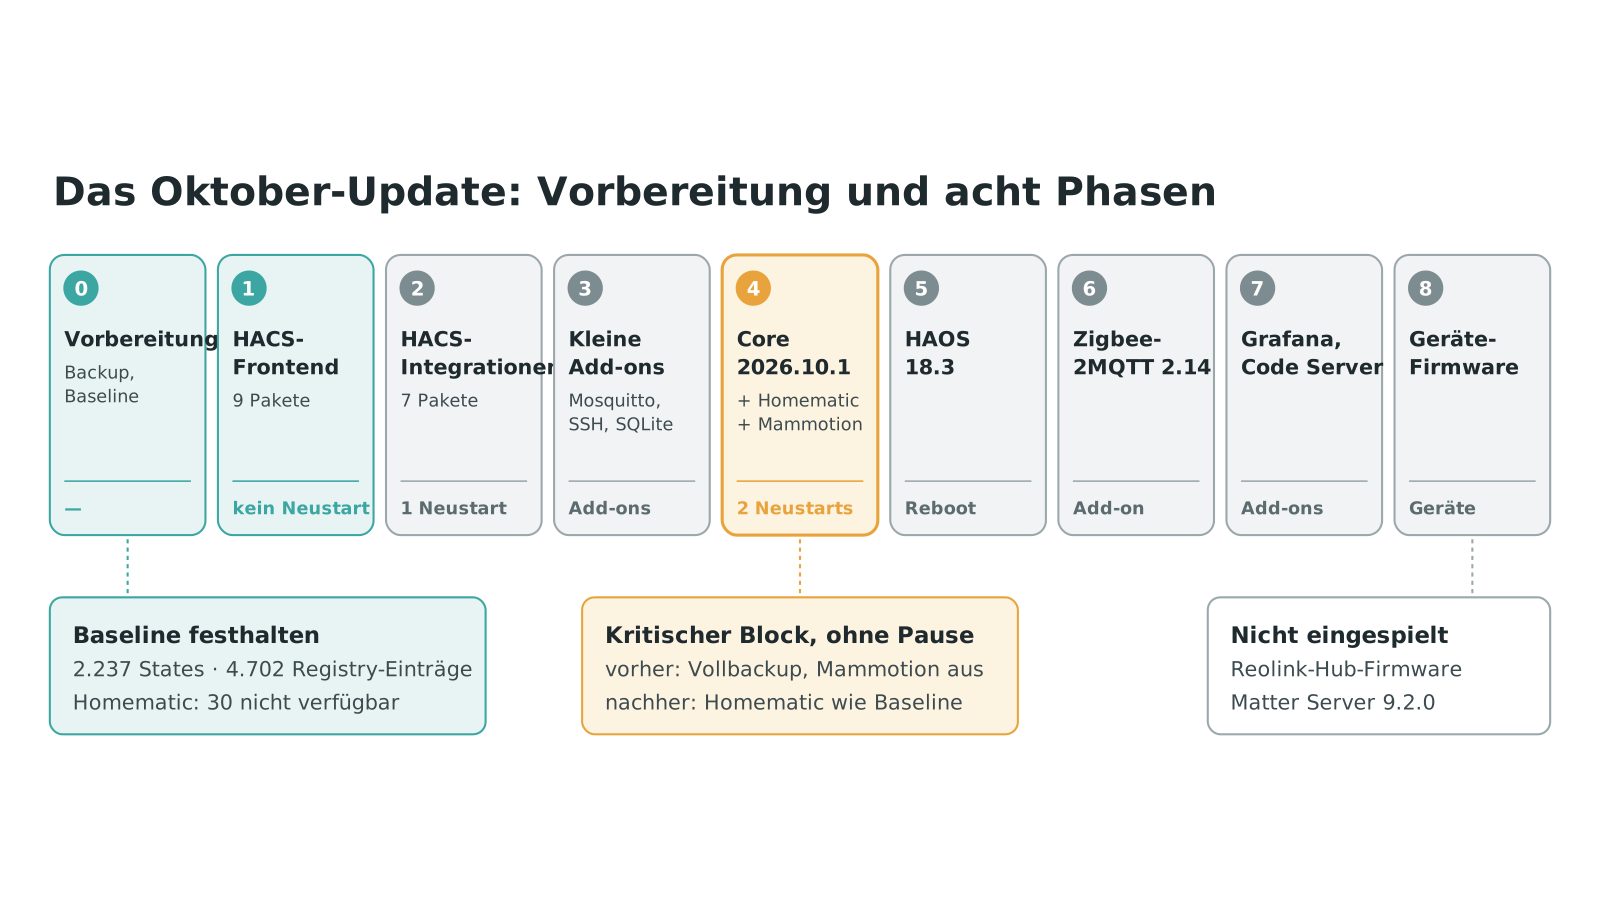
Der aufwendigste Einsatz war ein großes Update im Oktober. Mein System stand noch auf Core 2026.7. Insgesamt warteten 33 Updates: Core, Betriebssystem, Add-ons, HACS-Pakete, Firmware.
Bei so vielen Updates auf einmal überlagern sich Fehler leicht. Deshalb hat Claude vorher eine Analyse erstellt. Dafür hat es die Release Notes aller betroffenen Komponenten gelesen und gegen mein System abgeglichen. Nicht abstrakt, sondern konkret: Welche Integration ist bei mir aktiv? Wie viele Entities hängen daran? Welche Breaking Changes treffen mich überhaupt?
Dabei kam eine kritische Abhängigkeit heraus. Die Homematic-Integration, die ich nutze, legt in ihrer alten Version ab Core 2026.9 keine Entities mehr an. 125 Geräte: Licht, Rollläden, Fenster, Heizung. Das Core-Update und das Homematic-Update mussten also direkt nacheinander laufen, ohne Pause dazwischen.
Daraus entstand eine Checkliste mit acht Phasen. HACS-Frontend zuerst, weil es keinen Neustart braucht. Dann HACS-Integrationen, kleine Add-ons, der kritische Core-Block, das Betriebssystem, Zigbee2MQTT, der Rest. Firmware zum Schluss. Dazu eine Liste, was ausdrücklich nicht eingespielt wird. Etwa eine Reolink-Hub-Firmware, die den lokalen Login sperrt.
Vor dem Start hat Claude eine Baseline festgehalten. 2.237 States, 4.702 Registry-Einträge, 141 Entities nicht verfügbar. Für Homematic gesondert: 620 aktive Entities, davon 30 nicht verfügbar. Die Vorgabe für hinterher: Die 30 dürfen nicht mehr werden.
Ein Fund kam erst unterwegs. Beim Neustart nach einer frühen Phase hing die Mähroboter-Integration fünf Minuten. Der Mäher schlief, die Integration wartete auf ihn. In einem bekannten Fehlerbericht hatte genau dieses Muster dazu geführt, dass der Supervisor ein Core-Update zurückrollte. Also wurde der Eintrag vor dem Core-Update deaktiviert und danach wieder eingeschaltet.
Vor und nach den kritischen Phasen lief ein Snapshot-Vergleich. Nach dem Core-Block war das Ergebnis eindeutig: Homematic identisch zum Ausgangsstand. Nach dem Betriebssystem-Update: null Entities verschwunden, null neu ausgefallen.
Empfehlen ist nicht Entscheiden
Auch hier gab es einen Moment, der mich geärgert hat. Ich hatte gefragt, ob die nächste Bugfix-Version schon draußen ist. Claude hat daraufhin „Auf 10.2 warten“ als Entscheidung in die Checkliste geschrieben. Ohne mich zu fragen. Und ohne zu prüfen, ob die bekannte Regression mein System überhaupt betrifft. Sie betraf die FRITZ!SmartHome-Integration, die bei mir null Entities hatte.
Ich habe das angesprochen. Seitdem werden Empfehlungen als offene Frage notiert, bis ich entschieden habe. Das klingt nach Kleinigkeit. Bei einem System, das dein Zuhause steuert, ist es keine.
Was schiefgegangen ist
Ich will kein falsches Bild zeichnen. Es gab Fehler, und einer davon war teuer.
Mein Türschloss lief über eine veraltete Custom-Integration, die seit 2024 keine Updates mehr bekam. Die Umstellung auf die offizielle, lokale tedee-Integration hat Claude vorbereitet. Dazu gehörte die Prüfung, wo die alten Entities verwendet werden. Ergebnis: nur in drei Dashboards. Mit meiner Freigabe wurde der alte Eintrag gelöscht.
Danach fielen drei Automationen aus. Die nächtliche Verriegelung um 23:30 Uhr, die Entriegelung am Morgen und die Batteriewarnung. Alle drei waren gerätebasierte Automationen, im UI zusammengeklickt. Solche Automationen speichern keine Entity-ID, sondern eine interne Geräte-ID und eine Registry-UUID. Eine Suche nach lock.haustur findet sie nicht.
Die Automationen waren schnell repariert, diesmal entitätsbasiert. Die überstehen den nächsten Wechsel und sind per Suche auffindbar. Hätte ich es nicht bemerkt, wäre die Haustür nachts unverriegelt geblieben.
Ein zweiter Fall, einen Tag vorher: Claude meldete eine Wetterkarte als ungenutzt. Ich entfernte sie. Drei Karten waren kaputt. Ironischerweise hatte Claudes eigener Bericht sie kurz vorher noch korrekt als verwendet geführt.
Beide Fehler haben dieselbe Ursache. Eine Behauptung, dass etwas „nirgends verwendet“ wird, beruhte auf einer zu engen Prüfung. Ein falscher Negativbefund sieht aus wie ein sauberes Ergebnis. Genau das macht ihn gefährlich. Und dass ich jeweils selbst entschieden habe, hat nichts verhindert. Eine Freigabe ist nur so gut wie die Prüfung, auf der sie beruht.
Seitdem gilt bei mir:
- Vor jeder Löschung wird die Prüfung neu ausgeführt, nicht aus einer früheren Antwort übernommen.
- Gesucht wird nach Entity-ID und nach Geräte-ID und nach Registry-UUID.
- Jedes Suchmuster wird gegen einen bekannten Treffer getestet.
- Gruppen gleichartig benannter Entities mit Benutzer- oder Geräte-Suffix gelten als benutzt, bis das Gegenteil bewiesen ist. Manche Frontend-Module bauen ihre Entity-IDs erst zur Laufzeit zusammen. Die findet keine Textsuche.
Diese Regeln stehen in Claudes Gedächtnis. Fehlerfrei ist Claude damit nicht. Bei der Update-Analyse im Oktober ordnete es Geräte anhand ihres Namens einer Integration zu, statt in der Registry nachzusehen. Rauchmelder und Bewässerungsventil landeten bei Homematic, obwohl sie über Zigbee laufen. Ich habe es gemerkt, weil ich meine Geräte kenne. Darauf kommt es an.
Was du für den Einstieg brauchst
Wenn du das selbst ausprobieren willst, hier mein Vorschlag für den Anfang:
- Ein Backup. Vor allem anderen. Und ein Backup, von dem du weißt, dass du es zurückspielen kannst.
- Einen eigenen Long-Lived Token für Claude. Den kannst du jederzeit widerrufen.
- Eine CLAUDE.md mit klaren Regeln. Was darf gelesen, was darf geändert werden? Schreib explizit hinein, dass jede Änderung eine Freigabe braucht.
- Mit Lesen anfangen. Lass Claude eine Bestandsaufnahme machen: Wie viele Entities sind nicht verfügbar? Welche Integrationen laden nicht? Wo wächst die Datenbank? Das allein ist schon aufschlussreich.
- SSH erst, wenn du es brauchst. Für die meisten Fragen reichen REST- und WebSocket-API. Der Dateizugriff wird interessant, wenn es um YAML-Dateien oder die Datenbank geht.
Und dann: mitlesen. Claude Code zeigt jeden Befehl, den es ausführt, und fragt je nach Einstellung vorher um Erlaubnis. Diese Transparenz ist das wichtigste Sicherheitsnetz. Nutze sie.
Fazit
Claude Code hat mein Verhältnis zur Pflege meines Smart Homes verändert. Aufgaben, die ich lange vor mir hergeschoben habe, sind erledigt. Die Registry ist sauber. Die Datenbank wächst langsamer. Die Dashboards haben keine toten Verweise mehr. Und das letzte große Update lief nach Plan, mit Messwerten vor und nach jedem kritischen Schritt.
Der eigentliche Gewinn ist aber ein anderer. Ich verstehe mein System heute besser als vorher. Weil jeder Befund mit Daten belegt ist und jede Analyse als Dokument im Projektordner liegt. Ich weiß, warum 72 Integrationen nicht laden. Ich weiß, welche Sensoren die Datenbank füllen. Ich weiß, wie ich nach einem Update prüfe, ob etwas kaputt ist.
Die Kehrseite gehört genauso dazu. Ein KI-Agent arbeitet schnell und klingt dabei überzeugend. Auch dann, wenn er falsch liegt. Du brauchst klare Regeln, Backups und die Bereitschaft, nachzufragen. Die besten Ergebnisse kamen immer dann, wenn ich an einer Stelle gestutzt und gefragt habe: Bist du sicher?
Ein Kollege also. Ein sehr fleißiger, der nachts nicht müde wird. Aber einer, dem du auf die Finger schauen solltest.